
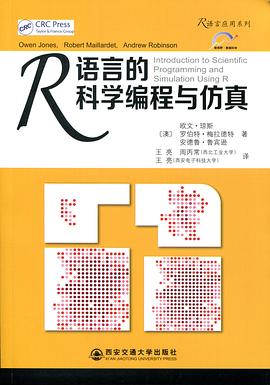

具体描述
由于其功能的多样性,免费编程语言R被广泛应用在统计计算与制图学中,并且它是一种非常适合科学编程的完全的函数式编程语言(functional programming language)。
这本书主要介绍了科学编程与随机建模的一些技巧。数学建模、特别是随机建模与科学编程具有紧密的联系,因为科学编程中的数值方法使利用数学模型处理实际问题变成一种可能。
以下是本书的结构,假定读者群不具备编程与统计的相关知识,书的内容由如下四部分组成:
R中的编程从如何获得并安装R开始(分别针对Windows、MacOS和Unix平台),然后介绍了基本的计算与程序流程,最后进一步讨论了基于函数的编程、数据结构、制图和面向对象的代码;
数值计算入门介绍求根方法、数值积分和优化问题中关于精度与编程效率等概念;
概率理论的独立介绍一直涉及到弱大数定律和中心极限定律,并且讲述了使用这些理论来处理点估计与区间估计问题;
数值仿真介绍了如何产生单独的随机变量、Monte-Carlo数值积分和方差缩减技巧。
在最后一部分中,本书使用了大量关于流行病、库存管理和植物种子扩散的例子来介绍如何进行随机建模。通篇使用的皆为可靠的方法,并提供了大量的示例、练习和实际工程问题。
不同于大部分R的指导书,本书不仅介绍了统计方法的应用,还介绍了如何将算法转化为代码。这一点对于那些不仅希望使用代码,而且想要设计代码的人是很有用的。
作者简介
目录信息
前言
第Ⅰ部分 编程
第1章 安装
第2章 基于R的计算环境
第3章 编程基础
第4章 输入和输出
第5章 函数化编程
第6章 复杂数据结构
第7章 绘图
第8章 R语言高级编程技术
第Ⅱ部分 数值计算
第9章 数值精度与程序的效率
第10章 求根
第11章 数值积分
第12章 最优化
第Ⅲ部分 概率与统计
第13章 概率
第14章 随机变量
第15章 离散型随机变量
第16章 连续型随机变量
第17章 参数估计
第Ⅳ部分 模 拟
第18章 模拟
第19章 蒙特卡洛积分
第20章 方差缩减
第21章 案例研究
第22章 案例选讲
R命令术语表
书中涉及的程序与函数
索引
· · · · · · (收起)
读后感
任何一种编程语言的学习在开始的时候都是一个痛苦的过程,因此在初始阶段选择任何一本书其实没有多大差别。差别在于你已经了解最基本的规则之后,培养自己编程的taste的时候。所以google才会有自己的r编程规范。 http://google-styleguide.googlecode.com/svn/trunk/google-r-...
评分任何一种编程语言的学习在开始的时候都是一个痛苦的过程,因此在初始阶段选择任何一本书其实没有多大差别。差别在于你已经了解最基本的规则之后,培养自己编程的taste的时候。所以google才会有自己的r编程规范。 http://google-styleguide.googlecode.com/svn/trunk/google-r-...
评分任何一种编程语言的学习在开始的时候都是一个痛苦的过程,因此在初始阶段选择任何一本书其实没有多大差别。差别在于你已经了解最基本的规则之后,培养自己编程的taste的时候。所以google才会有自己的r编程规范。 http://google-styleguide.googlecode.com/svn/trunk/google-r-...
评分任何一种编程语言的学习在开始的时候都是一个痛苦的过程,因此在初始阶段选择任何一本书其实没有多大差别。差别在于你已经了解最基本的规则之后,培养自己编程的taste的时候。所以google才会有自己的r编程规范。 http://google-styleguide.googlecode.com/svn/trunk/google-r-...
评分任何一种编程语言的学习在开始的时候都是一个痛苦的过程,因此在初始阶段选择任何一本书其实没有多大差别。差别在于你已经了解最基本的规则之后,培养自己编程的taste的时候。所以google才会有自己的r编程规范。 http://google-styleguide.googlecode.com/svn/trunk/google-r-...
用户评价
这本书的封面设计,说实话,第一眼看过去,感觉它就像是那种经典的、厚重的理工科教材,字体工整,排版一丝不苟。我当时在书店里翻阅时,主要被它封面上那些充满数学感的符号和图表所吸引。我本身对数据分析和建模领域比较感兴趣,所以看到“科学编程与仿真”这几个字,立马就有了深入了解的冲动。虽然我还没有完全读完,但光是目录和前几章的浏览,就能感受到作者在构建知识体系上的严谨。它似乎不仅仅是简单地介绍R语言的基础语法,而是更侧重于如何利用R语言这个强大的工具去解决实际的科研问题,比如如何设计一个有效的模拟实验,如何处理复杂的数值计算。这种深度和广度,让它看起来不像是一本入门指南,更像是一本可以放在案头随时查阅的“工具箱”。对于那些希望将R语言从简单的描述性统计提升到复杂建模和高性能计算阶段的读者来说,这本书的结构布局和内容深度无疑具有相当的吸引力。
评分我花了相当一部分时间去研究这本书中关于数值优化算法的那几个章节,那部分内容真是让我眼前一亮。我一直觉得,要在科研中真正做到“仿真”,就必须透彻理解底层算法的实现原理,而这本书在这方面做得相当出色。它没有停留在调用现成的函数层面,而是深入讲解了诸如牛顿法、梯度下降等经典方法的R语言实现细节,甚至还涉及到了一些并行计算的初步概念。这对于我这种需要跑大规模蒙特卡洛模拟的科研人员来说,简直是太及时了。我特别喜欢作者在解释复杂公式时,总能巧妙地将其转化为易于理解的R代码片段,形成了一种直观的对照感。这种“手把手”的教学方式,使得原本枯燥的数学理论变得鲜活起来,让人能立刻感受到编程的力量和局限性。我甚至根据书中的思路,优化了我正在进行的一个项目中的一个耗时计算模块,效率提升非常明显。
评分坦白讲,对于初学者来说,这本书的挑战性是存在的,它对读者的前提知识有一定的要求。你不能指望只通过这本书学会R语言最基础的输入输出和绘图。它更像是为那些已经具备一定编程基础,或者至少熟悉基础统计学概念的读者准备的“进阶武器”。我记得在某一章关于随机过程模拟的部分,作者直接引用了概率论中的复杂定义,然后无缝过渡到如何在R中构建相应的马尔可夫链模型。这种直接切入核心问题的风格,虽然高效,但也意味着如果基础不牢,可能会跟不上节奏。不过,正是这种对知识深度的坚持,才让这本书在众多R语言书籍中脱颖而出,成为一本真正能提升专业能力的书籍,而非仅仅是“入门”那么简单。
评分这本书的整体阅读体验,给我一种“厚重但绝不晦涩”的感觉。虽然主题是偏向硬核的科学计算,但作者的叙述风格非常注重逻辑的连贯性和条理清晰。我常常发现自己能在书中找到对某个特定统计模型R语言实现的详细剖析,这些剖析不仅展示了代码本身,更重要的是解释了代码背后的统计假设和计算约束。不同于市面上很多强调“快速上手”的教程,这本书更像是请了一位经验丰富的导师在身边,他不仅教你“怎么做”,更会告诉你“为什么这样做”。特别是关于数据结构在高性能计算中的应用那一节,作者对向量化操作和矩阵运算的讲解,清晰地展示了R语言在处理大规模数据时的性能瓶颈与优化方向,这一点对于我后续开发稳定、高效的分析流程至关重要。
评分我特别欣赏这本书在探讨“仿真”环节时所展现出的哲学思考。它不仅仅是将仿真视为一种技术手段,而是将其置于科学研究方法论的框架下进行探讨。作者在描述如何设计仿真实验时,花了不少篇幅来讨论随机数生成器的选择、收敛性的判断标准,以及如何量化和报告模拟结果的不确定性。这让我意识到,一个高质量的科学仿真,远不止于写出能跑起来的代码那么简单,它关乎实验设计的严谨性和结论的可信度。这种超越代码层面的讨论,让我对如何利用R进行更负责任、更具科学价值的模拟工作有了更深刻的认识。这本书在培养读者“工程师思维”和“科学家思维”的结合方面,做得非常成功。
评分 评分 评分 评分 评分相关图书



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.quotespace.org All Rights Reserved. 小美书屋 版权所有